미국 메릴랜드대와 서울대 공동연구진이 사람과 로봇의 작업 영상에서 물체의 움직임을 학습해 로봇 제어에 활용하는 인공지능 모델 ‘μ₀’를 개발했다. 물체를 싱크대에 넣기, 아몬드 붓기, 수건 펼치기 등 실제 로봇팔의 세 가지 작업에서 평균 성공률 91.7%를 기록했다. 영상으로 움직임을 배우는 과정과 특정 로봇의 실행 명령을 학습하는 과정을 분리한 방식이다.
메릴랜드대 고등컴퓨터연구소는 10월 2일 이 연구를 소개했다. 논문은 앞서 6월 11일 arXiv에 처음 제출됐으며, 6월 15일 수정본이 등록됐다. 공식 프로젝트에는 서울대 소속 Jusuk Lee, Jonghun Shin, H. Jin Kim이 공동저자로 명시돼 있다.
영상에서 3차원 이동경로 추출…동작별 언어 설명 연결
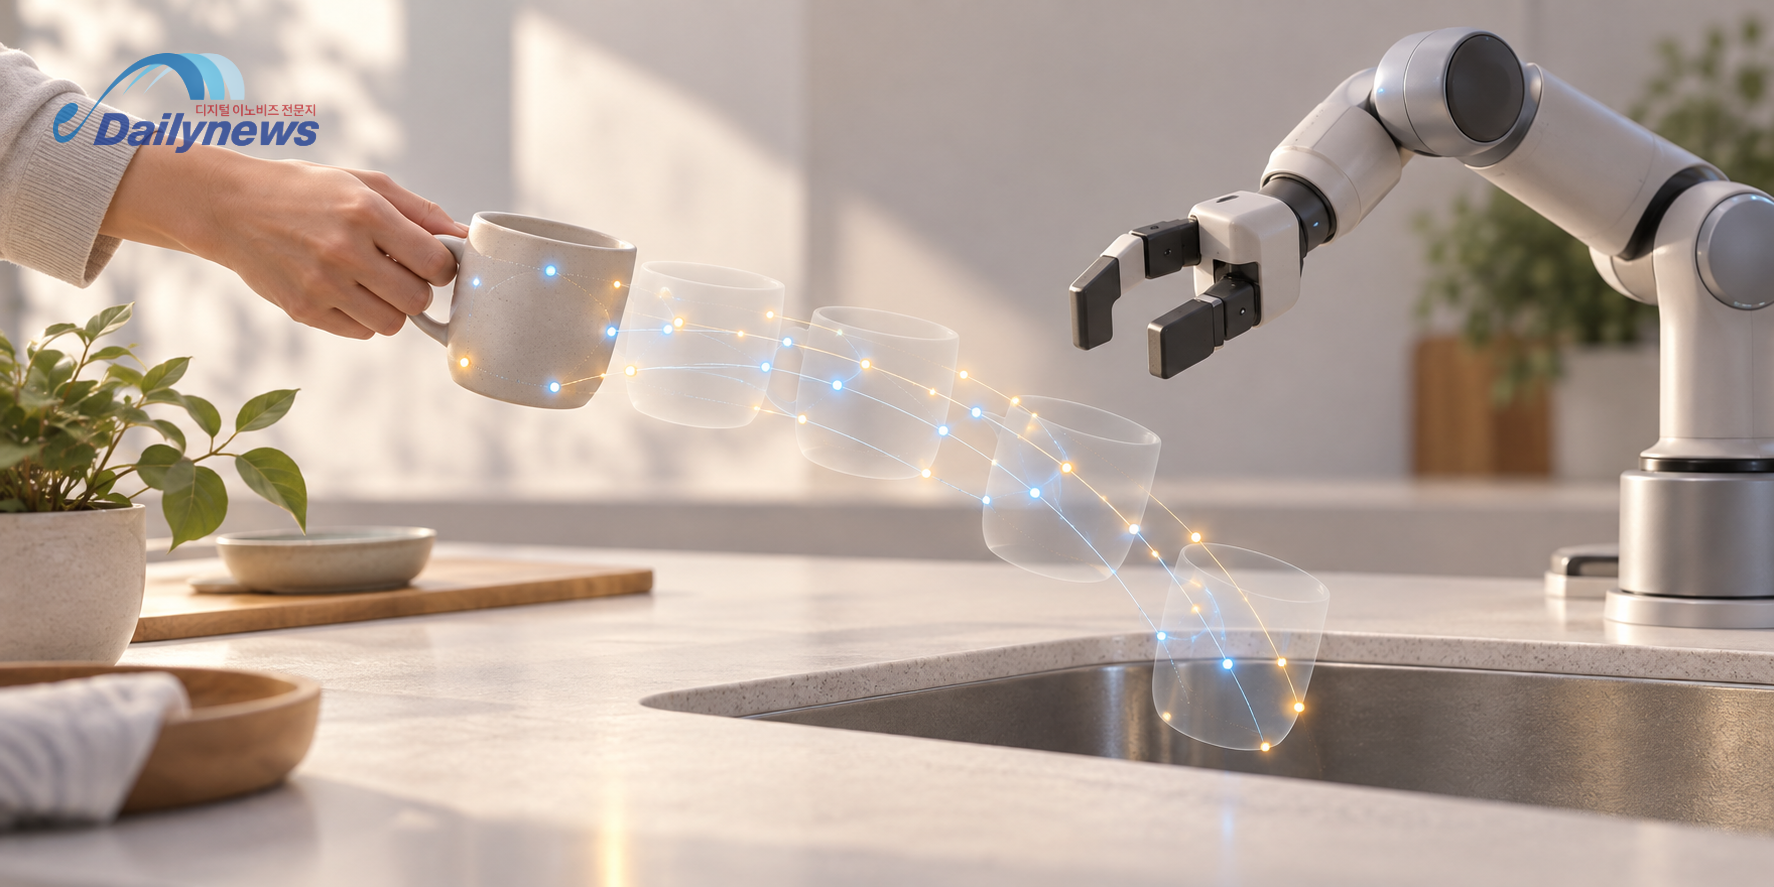
μ₀는 작업 중 장면의 변화를 예측하는 ‘월드모델’이다. 이미지와 언어 지시를 받으면 물체·도구·손·접촉 영역에서 선택한 지점들이 3차원 공간에서 어떻게 움직일지 계산한다. 컵을 싱크대에 놓으라는 지시가 주어지면 컵에 지정된 지점들의 미래 이동경로를 예측한다.
연구진은 학습자료를 만들기 위해 ‘TraceExtract’를 개발했다. 영상에서 작업과 관련된 지점을 선정하고 움직임을 추적해 3차원 궤적으로 변환한 뒤, 동작 구간마다 언어 설명을 붙인다. 이 과정에서 카메라 이동에 따른 화면 변화와 물체 자체의 움직임도 구분한다.
공식 프로젝트에서는 사람과 로봇의 작업에 대해 예측한 경로를 실제 경로와 비교할 수 있다. 시점을 바꾸면서 선택된 지점의 위치와 움직임을 입체적으로 살펴보는 기능도 제공한다.
움직임 예측과 로봇 제어 분리…실행 단계에는 시연자료 사용
영상 사전학습에는 영상과 함께 기록된 로봇 제어 명령이 필요하지 않다. 실제 로봇을 움직일 때는 별도의 행동 모델인 ‘Action Expert’를 학습한다.
연구진은 사전학습된 μ₀의 가중치를 고정하고, 행동 모델이 움직임 특징과 로봇의 관측·상태, 언어 지시를 받아 실행 명령을 생성하도록 구성했다. 해당 로봇의 시연자료는 이 행동 모델을 학습하는 단계에 사용된다.
실제 로봇팔 세 가지 작업서 평균 성공률 91.7%
실제 실험에는 두 손가락 집게가 달린 UR3 로봇팔을 사용했다.
작업별 학습 시연은 물체를 싱크대에 넣기 90개, 아몬드를 용기에 붓기 80개, 수건 펼치기 50개를 수집했다. 논문에 명시된 평가 횟수는 작업별 20회다.
μ₀와 행동 모델을 결합한 시스템의 평균 성공률은 91.7%였다. 비교 대상인 π₀보다 20.0%포인트, π₀.₅보다 11.7%포인트 높았다. 이 수치는 해당 로봇과 세 가지 작업에서 얻은 평가 결과다.
시뮬레이션에서는 π₀보다 높고 π₀.₅보다 낮아
주방 작업을 평가하는 RoboCasa365 시뮬레이션에서는 비교 대상에 따라 결과가 달랐다.
선정된 8개 작업의 평균 성공률은 μ₀가 30.25%, π₀가 25.25%, π₀.₅가 42.0%였다. μ₀는 π₀보다 5.0%포인트 높았지만 π₀.₅보다 11.75%포인트 낮았다.
논문은 비교 모델들의 사전학습 데이터가 동일하지 않으며, π₀.₅에는 대규모 로봇 행동 데이터가 사용됐다고 설명했다.
국내 연구진, 시각 인식·장면 예측·행동 평가 연구도 수행
μ₀와 별개로 국내 연구진이 참여한 관련 연구에는 DynaFLIP, RoFacto, RoboWorld가 있다. 각각 로봇 조작에 필요한 시각 표현, 움직임에 따른 장면 변화, 로봇 행동의 평가를 다룬다.
서울대·메릴랜드대·조지아공대의 ‘DynaFLIP’은 사람과 로봇의 영상에서 이미지·언어·3차원 움직임을 묶어 학습한다. 이를 통해 조작에 필요한 시각 표현을 만들며, 실행 단계에서는 이미지 기반 인코더를 사용한다. μ₀의 서울대 공동저자 세 명도 DynaFLIP 저자 명단에 포함돼 있다.
서울대·RLWRLD의 ‘RoFacto’는 제어 명령을 로봇의 예상 움직임으로 계산한 뒤 로봇 형상을 렌더링해 월드모델에 전달한다. 모델은 장면의 영상·깊이 정보와 예상 움직임을 바탕으로 주변 장면의 반응을 예측한다. 연구진은 학습에서 보지 못한 로봇팔과 손의 조합, 두 개의 로봇팔이 있는 장면에 대한 영상 예측 사례를 공개했다.
KAIST·Config의 ‘RoboWorld’는 로봇 행동에 따른 영상을 생성하는 월드모델과 작업 진행 정도를 판단하는 시각언어모델을 결합했다. 실제 로봇 평가인 RoboArena와 비교한 Pearson 상관계수는 0.989, Spearman 순위상관계수는 0.970으로 보고됐다. 두 지표는 해당 평가에서 결과의 변화와 순위가 일치하는 정도를 나타낸다.
코드·가중치 배포 안내…영상 추출 시스템은 공개 준비 중
μ₀ 공식 저장소에는 학습·평가 코드가 공개돼 있으며, 모델 가중치와 평가자료의 배포 위치도 안내돼 있다.
다만 10월 5일 확인한 학습 문서는 TraceExtract와 그 출력 데이터를 공개 준비 중이라고 명시했다. 현재 문서는 같은 형식의 자체 데이터를 구성해 학습하는 절차를 제공한다.
공개 학습 예시는 메모리 48GB의 그래픽처리장치 한 장에서 배치 크기 2로 실행하는 설정이다. 학습 중 메모리 사용량을 줄이는 gradient checkpointing도 적용한다. 해당 문서에는 전체 연구에 투입된 비용이나 기존 방식 대비 비용 절감률이 제시돼 있지 않다.
힘·촉각은 명시적으로 다루지 않아…다양한 로봇 검증 남아
메릴랜드대는 영상 추적과 동작 설명 생성 과정의 오류가 학습에 영향을 줄 수 있다고 밝혔다.
모델이 힘과 촉각을 명시적으로 다루지 않는 점도 한계로 설명했다. 더 다양한 로봇과 작업에서의 성능은 아직 검증되지 않았으며, 현재 공개된 실제 로봇 실험은 UR3 로봇팔의 세 가지 조작 작업을 대상으로 한다.
출처: 메릴랜드대 고등컴퓨터연구소 「Teaching Robots to Follow the Motion」(2026.10.2) · 공동연구진 「μ₀: A Scalable 3D Interaction-Trace World Model」(2026.6.11 최초 제출, 6.15 수정) · 연구진 공식 μ₀ 프로젝트·학습 문서·DynaFLIP·RoFacto·RoboWorld(2026.10.5 확인)
댓글
0